语义层 Semantic Layer 默认功能
当数据平台学会「理解」业务:把数据库(结构化)与知识库(非结构化)在语义层融合,让 Agent 从「会写 SQL 的搜索引擎」变成能归因、能给建议的业务伙伴。
已实现:指标语义层(数据 × 语义结合)默认功能
语义融合的第一块已落地——指标不再只是数字,每个指标都绑定「业务口径 + 计算公式 + 关联知识文档」(即 Property Federation 的最小实现)。
| 构成 | 含义 | 示例(退款率) |
|---|---|---|
| 取值(数据) | 由度量 → 参数化 SQL → OLAP 实时计算 | 33.33% |
| 口径 definition(语义) | 业务定义,治理单一真相 | 退款订单数 ÷ 订单总数(status=refunded) |
| 公式 formula | 可追溯的计算表达式 | refunded_order_count / orders |
| 关联知识 knowledge | 绑定到知识库口径文档 | 退款率定义.md |
接口:GET /api/semantic/metrics(指标目录 + 口径)· GET /api/semantic/metrics/values(取值)· GET /api/semantic/explain?q=退款率(取值+口径+公式+知识 一次返回)。LLM 绝不直出 SQL——指标由注册表声明、编译为参数化 SQL。
Entity Hub:实体上下文包
语义融合的第二块也已落地:GET /api/semantic/entity?object=account&id=A3001 把一个实体的结构化数据 + 关联对象(外键关系)+ 关联知识(知识库挂到该对象的文档)组装成统一上下文包。对话里问「把客户 A3001 的完整上下文给我」→ 助手用 entity_context 工具取整包,综合「客户概况 + 关联用户 + 关联质检报告」作答——即 Entity Hub 把同一实体在 DB 与 KB 中的存在对齐。
Relationship Cross-linking:关系跨链归因链
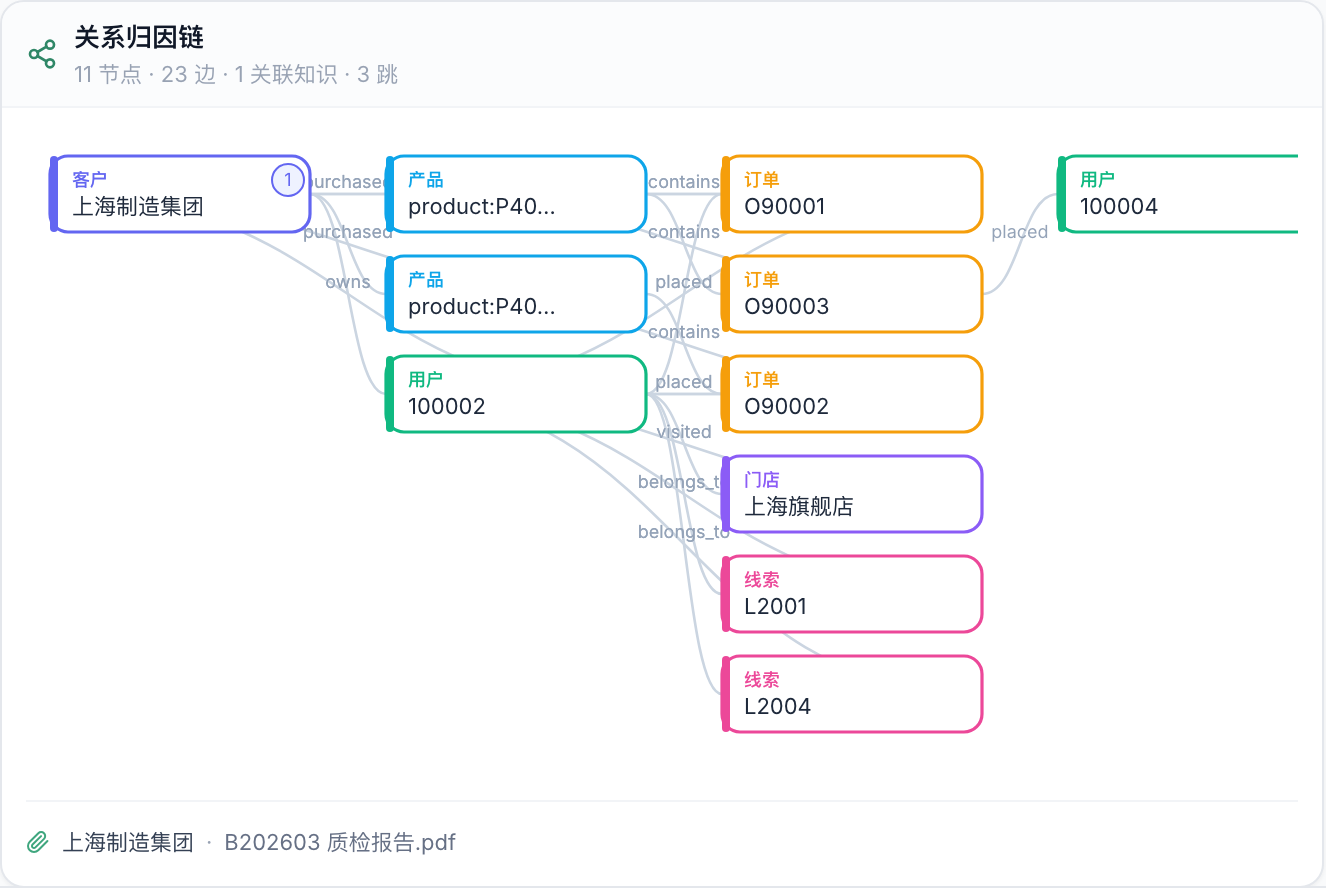
第三块也已落地:GET /api/semantic/chain?object=account&id=A3001 从实体出发沿关系图多跳遍历(正/反向外键),合并为一张 nodes + edges 图,每个节点聚合其关联知识文档——把 DB 关系与 KB 知识跨链成一条可走的归因链。对话里说「从客户 A3001 走一条归因链」→ 助手用 relation_chain 工具:起点(含质检报告) → 第1跳(用户/产品) → 第2跳(订单/门店/线索)… 串成链路叙述。实测从 A3001 展开 11 节点 / 23 边 / 3 跳。
一、问题:数据平台只走了第一公里
大多数数据平台(含传统 CDP / BI)只有一层 SQL 层:你问什么它查什么,但它不知道「退款率」是什么意思、8% 是否异常、退款和批次质量有没有关系。AI Agent 出现后,Agent 能写 SQL,但依然不懂业务——它能输出「退款率 8.2%」,却无法回答「给我分析一下」,因为它不知道 SKU 背后有供应链、批次里有质检报告。
数据平台只告诉你「发生了什么」,剩下的「为什么、怎么办」全靠人来走。缺少的,就是语义层。
二、什么是语义层
介于原始数据与上层应用之间的翻译层,做三件事:
🧥给冷数据穿暖衣
status=refunded 翻译成业务语言:「客户退款了,原因是质量问题还是尺寸不符?」
🧩把碎片拼成全景
订单表、退款表、质检报告、供应商档案、客服对话拼成一条完整的业务故事线。
🧠让 AI 看懂上下文
Agent 拿到的不是一个数字,而是「业务上下文包」= 数字 + 定义 + 关联知识 + 异常判断。
关键洞察:让 AI 能回答业务问题的,不是写 SQL 的能力,而是理解业务的能力——这需要把数据库(结构化)和知识库(非结构化)在语义层融合起来。
三、语义融合架构
融合层由三部分组成:
①Entity Hub 实体中心
把同一业务实体(用户/订单/商品/供应商/批次)在数据库与知识库中的存在形式统一。DB 里 user_id=12345 是一行记录,KB 里是一份画像文档 + 客服对话摘要——Agent 查一个实体,同时拿到精确数据和业务上下文。
②Property Federation 属性联邦
数据库字段与知识库属性做声明式绑定。user.total_orders 不只是数字,还关联口径说明(「= 所有 completed 订单数」)、历史趋势、行业基准——字段成为有业务生命的概念。
③Relationship Cross-linking 关系跨链
数据库外键关系 + 知识库实体关系合并为一张统一关系图。DB 知道「用户→订单」一对多,KB 知道「用户→物流投诉」业务关联,合并后可走完整归因链。
一条完整的归因链
四、与知识库的融合(双源)
语义层的非结构化一极正是 知识库 Knowledge。两者的关系:
| 层 | 承载 | 在语义层中的角色 |
|---|---|---|
| 结构化数据源 | 对象模型 / 画像宽表 / OLAP 表 | 提供精确数值与外键关系(DB 侧) |
| 非结构化知识源 | 知识库:文档 / 质检报告 / 客服对话 / 供应商档案 / 口径说明 | 提供业务上下文、定义口径、异常基准(KB 侧) |
知识库支持多模态文件存储 + 关联到对象记录(如 account/A3001),这正是语义融合的落点:知识库文件经 Entity Hub 与数据库实体对齐、经 Property Federation 绑定到字段口径、经关系跨链并入统一关系图。能力组成:
- 知识切片与向量化 —— 知识库文件解析、切片、Embedding,支持语义检索。
- 实体对齐 —— 文件/段落与对象记录的自动 / 人工对齐(扩展现有「关联对象」能力)。
- 口径绑定 —— 把字段(如
total_orders)绑定到知识库里的口径说明文档,回答时一并给出定义。 - 归因链编排 —— Agent 沿统一关系图跨 DB / KB 多跳,构建归因链并生成建议。
五、一个真实例子
同一问题「上周退款率为什么突然升高?」,Agent 的处理不再是「查一下数据库」:
- 意图理解:混合型问题,需定量(退款率)+ 定性(原因)。
- 实体解析:「退款率」→ Entity Hub 定位到
orders.status=refunded数据集 + 行业基准知识库文档。 - 数据采集(DB 侧):上周 8.2%(前 4 周均值 2.7%,3 倍);78% 退款来自同一 SKU FUR-2026-WINTER;质量问题集中在 B202603 批次。
- 知识关联(KB 侧):B202603 质检报告「色泽不均,质检退回率 15%」;供应商 A 投诉率同比 +300%;行业基准 3–5%。
- 归因链构建:供应商 A 的 B202603 批次色泽不均 → 集中在该 SKU → 上周大量交付新客 → 新客退款 → 退款率飙升。
六、范式对比
| 维度 | 传统数据平台 | 语义融合平台(Quasar) |
|---|---|---|
| 核心模型 | 表 + 字段 | 实体 + 概念 + 关系 |
| 查询方式 | SQL / NL → SQL | 意图 → 语义表达式 → 多源路由 |
| 知识来源 | 仅数据库 | 数据库 + 知识库双源 |
| 回答质量 | 精确但孤立 | 精确 + 有上下文 + 可归因 |
| 用户角色 | 分析师(会写 SQL) | 业务人员(说人话) |